

AI Speech Recognition · 2 款工具
2026 最佳 AI Speech Recognition
对比多款 AI 语音识别工具,覆盖语音转文字、实时字幕、会议记录、多语言转录和语音输入——从直播字幕到开发者 API。

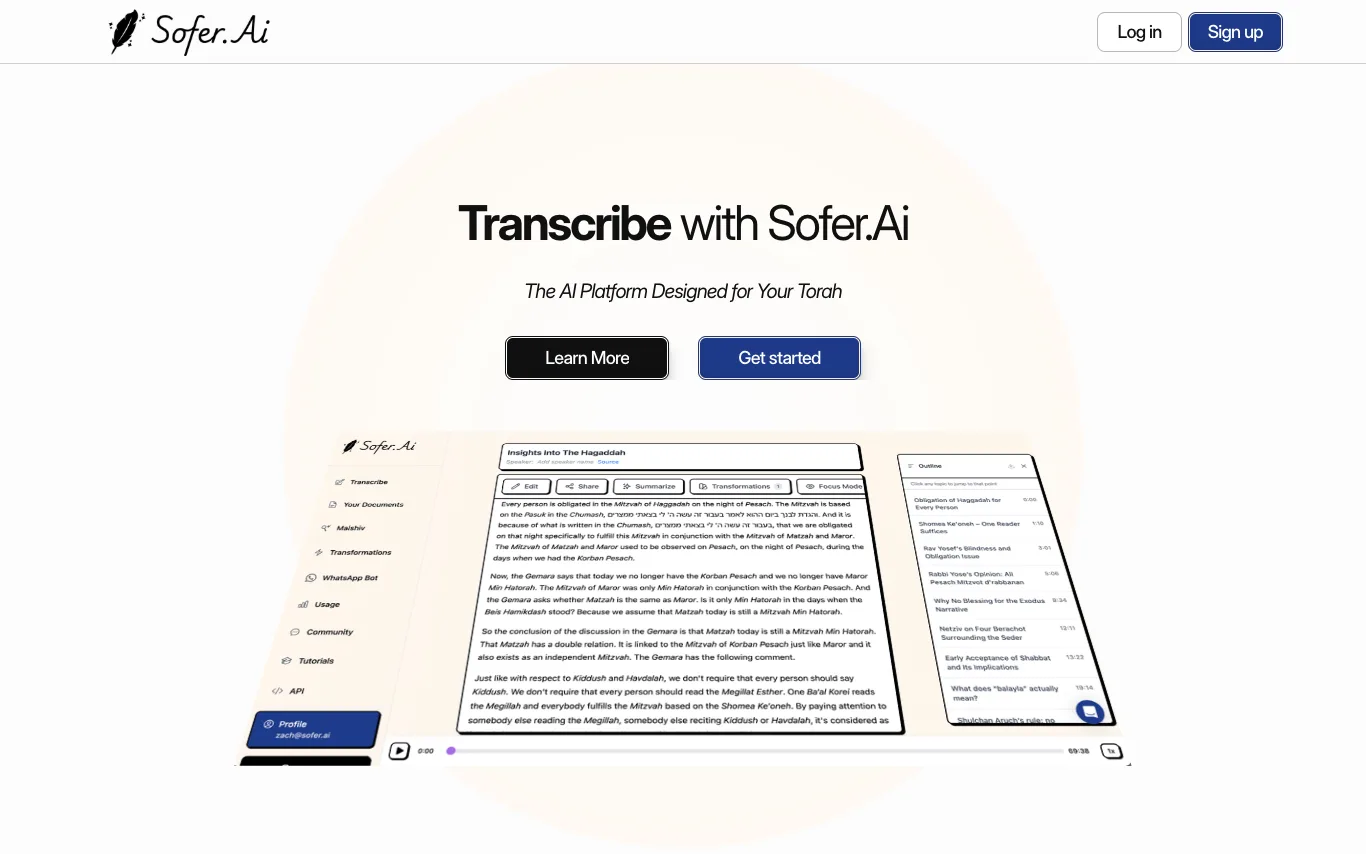

什么是 AI 语音识别
AI 语音识别(ASR,也就是常说的语音转文字)借助深度学习模型,把语音音频自动转换成文字。它既能转写录音,也能处理实时音频流,自动加标点和时间轴,还能区分不同说话人并支持多种语言。这类工具既包括会议记录和访谈转写,也包括视频字幕生成,以及给开发者调用的语音转文字 API。
这些工具能做什么
- 实时与批量音频转文字
- 自动标点、断句与时间轴
- 区分说话人,标注发言归属
- 多语种识别与语种自动检测
- 导出 SRT、VTT 字幕文件
- 流式 API 与语音指令集成
谁在用 AI 语音识别
01
会议与访谈记录
把电话、访谈、课程转成可检索的文字稿,自动标注说话人并沉淀要点。
02
视频与播客字幕
为短视频、播客生成准确字幕和多语种翻译字幕,让创作者更快发布内容。
03
开发者语音应用
通过流式语音转文字 API,为产品接入语音输入、语音指令或实时字幕。
04
无障碍与语音输入
帮助听障用户跟上音频内容,也让任何人用嘴代替打字、免手书写。
工作原理
语音识别模型用海量音频和对应的正确文字稿训练,学会把声音特征映射成词语。面对新音频时,它预测最可能的文字,并结合上下文在读音相近的词之间做出选择、补上标点。做实时字幕时,它以流式方式处理音频,说话的同时就能在零点几秒内返回文字。