


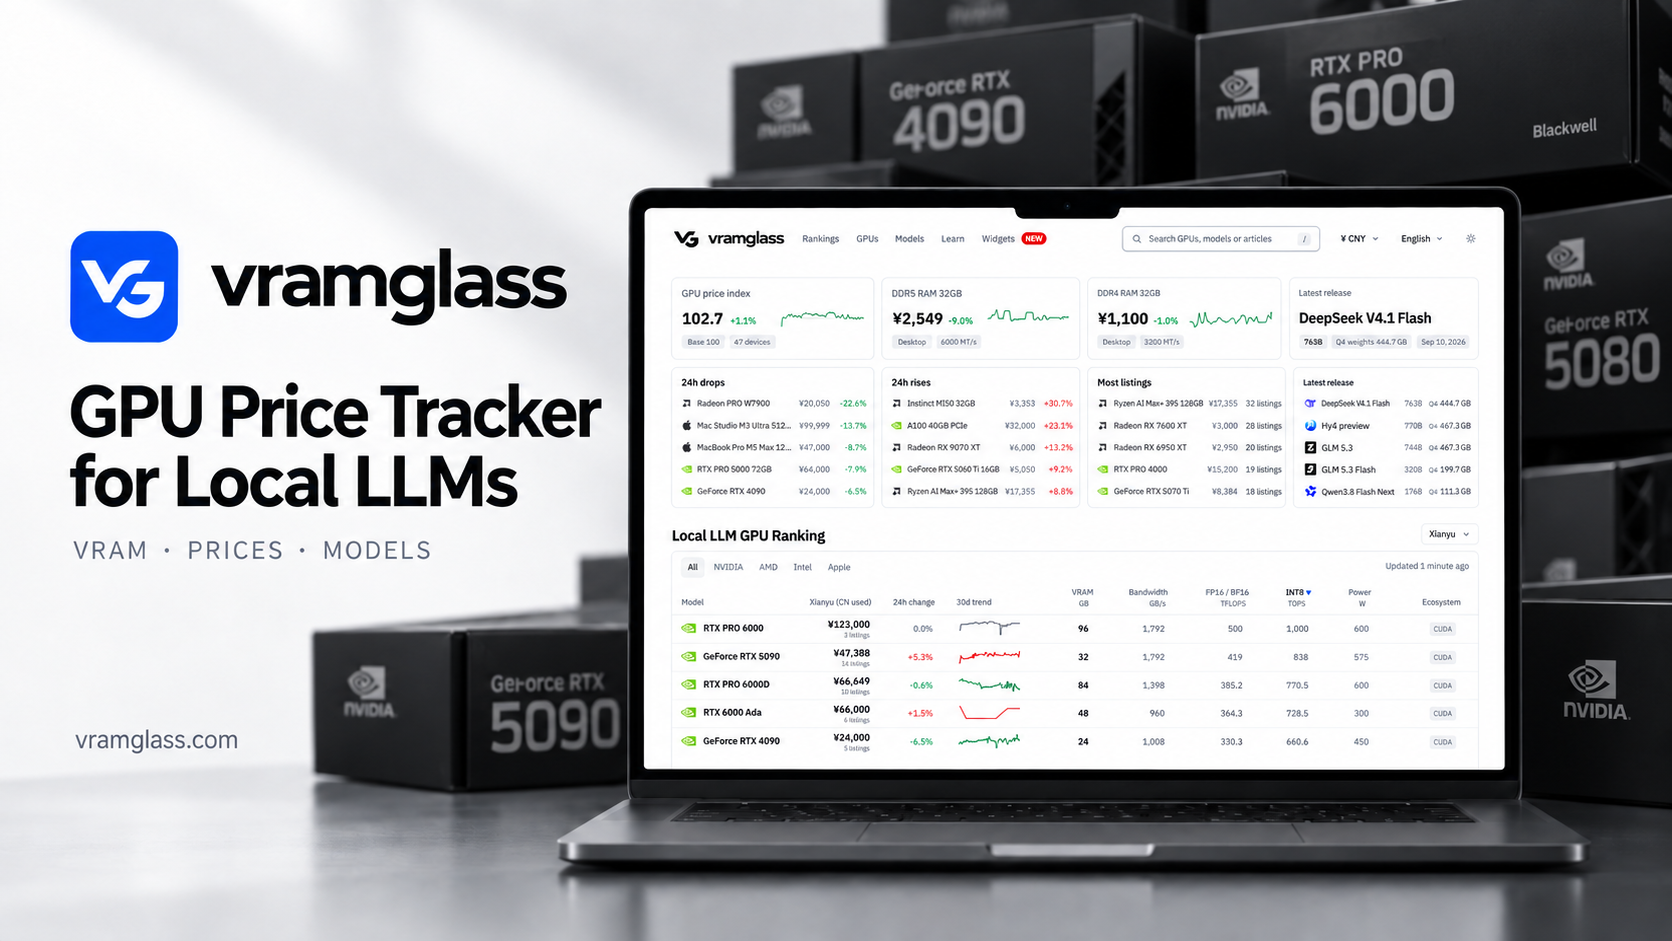
VRAMGlass 是一个免费的网页工具,帮想在本地运行大语言模型的人挑选硬件。你可以按显存容量、显存带宽、功耗和软件生态比较 GPU;浏览开源权重模型家族及各量化版本的权重大小,再参考有方法说明的显存与适配估算,规划自己真正需要的硬件。
2026 最佳 Large Language Models (LLMs)
对比主流大语言模型(大模型)——GPT、Claude、Gemini 及国产开源大模型,从中文能力、上下文长度、代码水平、API 价格到私有化部署一站看全。
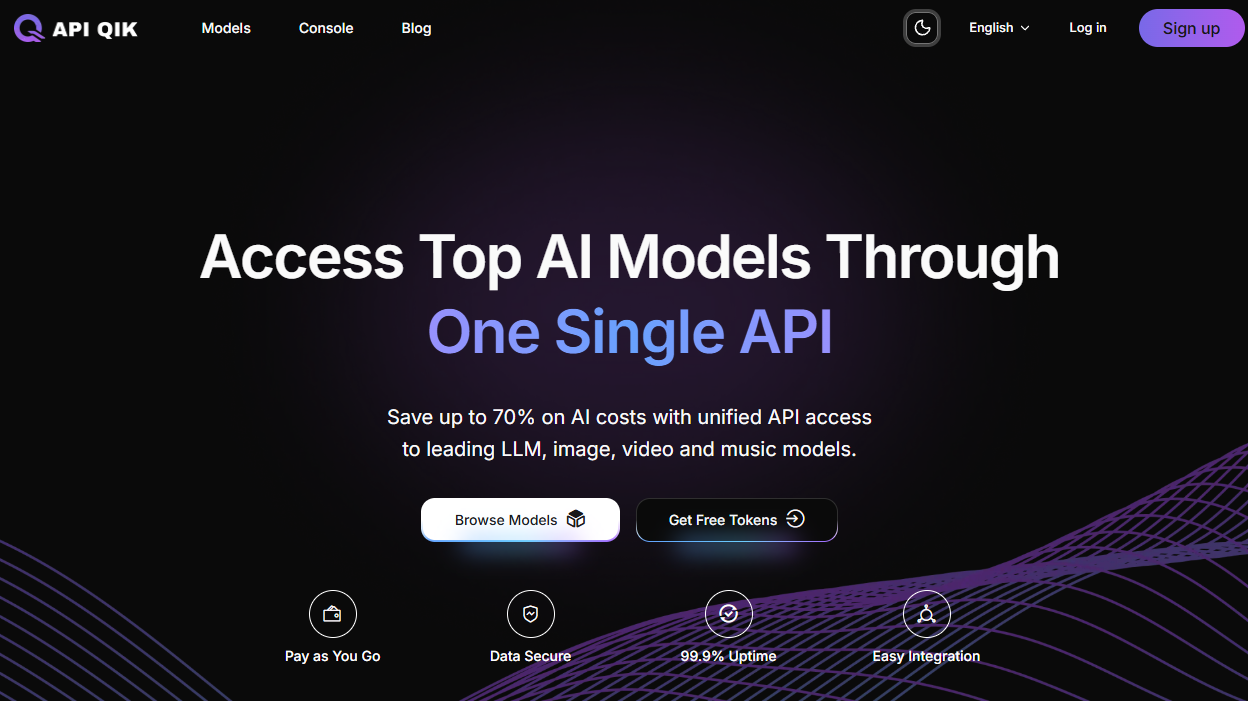
APIQIK 是一个统一的 AI API 平台,开发者通过一个兼容 OpenAI 的 API,就能使用主流大语言模型,以及图片、视频、音乐等生成式 AI 模型。 APIQIK 用统一的 API 把开发者和企业连接到主流大语言模型、视觉模型和生成式 AI 服务。平台省去了管理多家 AI 服务商的麻烦,简化集成,减少开发开销,让团队以更高的效率和更低的成本构建和扩展 AI 应用。 无论初创公司还是大型企业,都可以用 APIQIK 更快上线 AI 功能,并以更可预期的方式扩展,减轻基础设施负担。

DMC 提供一个 API,用来访问精选的中国开源和开放权重 AI 模型。平台采用自营基础设施,注重数据的负责任处理、响应速度、服务稳定性和有竞争力的价格。你可以在 DMC 模型目录中查看适合对话、推理、编程和工具调用等场景的模型,以及它们的能力和价格。 如果你在运行 Cursor 或 Cline 这类 Agent 工作流,用量大多是输入,0.1 倍的上下文缓存价格能明显降低成本。按 80% 的典型缓存命中率计算,1 美元可买到的等效输入 token 如下: - Kimi-K2.6:约 1075 万 token - GLM-5.1 / 5.2:约 729 万 token - Kimi-K2.7:约 629 万 token - Kimi-K3:约 149 万 token DMC 提供高并发、零日志和较大的缓存节省。
AIModelFind 是一个免费的 AI 模型目录,收录文本、图像、视频和音频模型,列出每个模型在各家服务商的价格,每天更新。
相关分类
什么是大语言模型(LLM)
大语言模型(LLM)是在海量文本上训练、以预测下一个 token 为目标的神经网络,因此具备较强的语言、代码与推理能力。你可以通过对话应用、API 或本地私有化部署来使用它,让它遵循指令、回答问题、写改代码并处理长文档。它既包括 GPT、Claude、Gemini 等闭源模型,也包括 Llama、Mistral、通义千问、DeepSeek 等开源权重模型。
大模型能做什么
- 遵循指令完成写作、分析与推理任务
- 多语言代码的生成、解释与调试
- 超长上下文,读取整篇文档或代码库
- API 支持流式输出、函数调用与 JSON
- 多模态输入:图片、音频,部分支持视频
- 开源权重可微调并私有化本地部署
谁在用大语言模型
01
基于 API 开发的工程师
调用云端大模型,为应用接入对话、信息抽取或智能体能力。
02
横向对比前沿模型的团队
在推理、代码、中文、价格与速度上比较 GPT、Claude 与 Gemini。
03
用开源权重自建部署
本地运行 Llama、通义千问或 DeepSeek,兼顾隐私、成本与离线可控。
04
做微调的研究者与开发者
用自有数据把基座模型适配到特定领域、语气或任务。
大语言模型的工作原理
大模型先在海量文本上训练、学习预测下一个 token,再用人类反馈微调,使它更会遵循指令、给出有用回答。推理时它读取你的提示与此前对话,在固定的上下文窗口内逐个 token 生成回复。检索、工具调用与微调可以为它补充实时数据、外部动作或特定领域能力。